
Unicode Han Character 'CJK UNIFIED IDEOGRAPH-2A1C8' (U+2A1C8) |
  |
CJK UNIFIED IDEOGRAPH-2A1C8
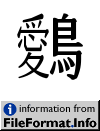
CJK UNIFIED IDEOGRAPH-2A1C8
| Name | CJK UNIFIED IDEOGRAPH-2A1C8 |
| Block | CJK Unified Ideographs Extension B |
| Category | Letter, Other [Lo] |
| Script | Han (Hani) |
| Combine | 0 |
| BIDI | Left-to-Right [L] |
| Version | Unicode 3.1.0 (March, 2001) |
| Unicode Han Data | |
|---|---|
| kMorohashi | 47420 |
| kIRG_GSource | GHZ-74665.08 |
| kIRG_JSource | JMJ-055797 |
| kIRGHanyuDaZidian | 74665.080 |
| kKangXi | 1503.161 |
| kHanyuPinyin | 74665.080:ài |
| kJapanese | ケイ |
| kHanYu | 74665.080 |
| kMojiJoho | MJ055797 |
| kRSUnicode | 196.13 |
| kMandarin | ài |
| kTotalStrokes | 24 |
| HTML Entity (decimal) | 𪇈 |
| HTML Entity (hex) | 𪇈 |
| How to type in Microsoft Windows | Alt +2A1C8 |
| UTF-8 (hex) | 0xF0 0xAA 0x87 0x88 (f0aa8788) |
| UTF-8 (binary) | 11110000:10101010:10000111:10001000 |
| UTF-16 (hex) | 0xD868 0xDDC8 (d868ddc8) |
| UTF-16 (decimal) | 55,400 56,776 |
| UTF-32 (hex) | 0x0002A1C8 (2a1c8) |
| UTF-32 (decimal) | 172,488 |
| C/C++/Java source code | "\uD868\uDDC8" |
| Python source code | u"\U0002A1C8" |
| More... | |
| Java Data | |
|---|---|
| string.toUpperCase() | 𪇈 |
| string.toLowerCase() | 𪇈 |
| Character.UnicodeBlock | CJK_UNIFIED_IDEOGRAPHS_EXTENSION_B |
| Character.charCount() | 2 |
| Character.getDirectionality() | DIRECTIONALITY_LEFT_TO_RIGHT [0] |
| Character.getNumericValue() | -1 |
| Character.getType() | 5 |
| Character.isDefined() | Yes |
| Character.isDigit() | No |
| Character.isIdentifierIgnorable() | No |
| Character.isISOControl() | No |
| Character.isJavaIdentifierPart() | Yes |
| Character.isJavaIdentifierStart() | Yes |
| Character.isLetter() | Yes |
| Character.isLetterOrDigit() | Yes |
| Character.isLowerCase() | No |
| Character.isMirrored() | No |
| Character.isSpaceChar() | No |
| Character.isSupplementaryCodePoint() | Yes |
| Character.isTitleCase() | No |
| Character.isUnicodeIdentifierPart() | Yes |
| Character.isUnicodeIdentifierStart() | Yes |
| Character.isUpperCase() | No |
| Character.isValidCodePoint() | Yes |
| Character.isWhitespace() | No |
