
Unicode Han Character '(ancient form of 飲) to drink; to swallow' (U+3C43) |
  |
(ancient form of 飲) to drink; to swallow
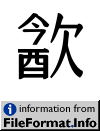
(ancient form of 飲) to drink; to swallow
| Name | (ancient form of 飲) to drink; to swallow |
| Block | CJK Unified Ideographs Extension A |
| Category | Letter, Other [Lo] |
| Script | Han (Hani) |
| Combine | 0 |
| BIDI | Left-to-Right [L] |
| Version | Unicode 3.0.0 (September, 1999) |
| Unicode Han Data | |
|---|---|
| kIRG_GSource | GKX-0571.26 |
| kPhonetic | 1564 |
| kSBGY | 329.38 |
| kCangjie | OWNO |
| kGSR | 0651i' |
| kIRG_KSource | KC-08040 |
| kKangXi | 0571.260 |
| kIRG_TSource | T3-4C68 |
| kJapanese | イン のむ |
| kMojiJoho | MJ001925 |
| kRSUnicode | 76.11 |
| kXHC1983 | 1379.020:yǐn |
| kDefinition | (ancient form of 飲) to drink; to swallow |
| kMorohashi | 16184 |
| kSMSZD2003Index | 342.03 |
| kCihaiT | 732.101 |
| kIRG_JSource | JMJ-001925 |
| kCantonese | jam2 |
| kIRGHanyuDaZidian | 32150.080 |
| kHanYu | 32150.080 |
| kIRG_KPSource | KP1-4EE6 |
| kFanqie | 於錦 |
| kMandarin | yǐn |
| kTotalStrokes | 15 |
| HTML Entity (decimal) | 㱃 |
| HTML Entity (hex) | 㱃 |
| How to type in Microsoft Windows | Alt +3C43 |
| UTF-8 (hex) | 0xE3 0xB1 0x83 (e3b183) |
| UTF-8 (binary) | 11100011:10110001:10000011 |
| UTF-16 (hex) | 0x3C43 (3c43) |
| UTF-16 (decimal) | 15,427 |
| UTF-32 (hex) | 0x00003C43 (3C43) |
| UTF-32 (decimal) | 15,427 |
| C/C++/Java source code | "\u3C43" |
| Python source code | u"\u3C43" |
| More... | |
| Java Data | |
|---|---|
| string.toUpperCase() | 㱃 |
| string.toLowerCase() | 㱃 |
| Character.UnicodeBlock | CJK_UNIFIED_IDEOGRAPHS_EXTENSION_A |
| Character.charCount() | 1 |
| Character.getDirectionality() | DIRECTIONALITY_LEFT_TO_RIGHT [0] |
| Character.getNumericValue() | -1 |
| Character.getType() | 5 |
| Character.isDefined() | Yes |
| Character.isDigit() | No |
| Character.isIdentifierIgnorable() | No |
| Character.isISOControl() | No |
| Character.isJavaIdentifierPart() | Yes |
| Character.isJavaIdentifierStart() | Yes |
| Character.isLetter() | Yes |
| Character.isLetterOrDigit() | Yes |
| Character.isLowerCase() | No |
| Character.isMirrored() | No |
| Character.isSpaceChar() | No |
| Character.isSupplementaryCodePoint() | No |
| Character.isTitleCase() | No |
| Character.isUnicodeIdentifierPart() | Yes |
| Character.isUnicodeIdentifierStart() | Yes |
| Character.isUpperCase() | No |
| Character.isValidCodePoint() | Yes |
| Character.isWhitespace() | No |
