
Unicode Han Character 'mercury (chemical element); hectogram' (U+5161) |
  |
mercury (chemical element); hectogram
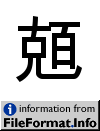
mercury (chemical element); hectogram
| Name | mercury (chemical element); hectogram |
| Block | CJK Unified Ideographs |
| Category | Letter, Other [Lo] |
| Script | Han (Hani) |
| Combine | 0 |
| BIDI | Left-to-Right [L] |
| Version | Unicode 1.1.0 (June, 1993) |
| Unicode Han Data | |
|---|---|
| kCNS1986 | 1-227D |
| kPhonetic | 430 |
| kCangjie | JUMA |
| kKorean | PAYK |
| kIRG_HSource | HB0-A25D |
| kIRG_TSource | T1-227D |
| kBigFive | A25D |
| kHanYu | 10274.031 |
| kCNS1992 | 1-227D |
| kCCCII | 216959 |
| kTotalStrokes | 13 |
| kIRG_GSource | GE-315E |
| kEACC | 216959 |
| kKangXi | 0125.211 |
| kJapanese | ヘクトグラム |
| kMojiJoho | MJ007256 |
| kRSUnicode | 10.11 |
| kDefinition | mercury (chemical element); hectogram |
| kMorohashi | 01394 |
| kCihaiT | 140.602 |
| kUnihanCore2020 | HMT |
| kIRG_JSource | JMJ-007256 |
| kCantonese | baak3 |
| kIRGHanyuDaZidian | 10274.031 |
| kIICore | AT |
| kDaeJaweon | 0266.060 |
| kXerox | 302:057 |
| kTaiwanTelegraph | 0333 |
| HTML Entity (decimal) | 兡 |
| HTML Entity (hex) | 兡 |
| How to type in Microsoft Windows | Alt +5161 |
| UTF-8 (hex) | 0xE5 0x85 0xA1 (e585a1) |
| UTF-8 (binary) | 11100101:10000101:10100001 |
| UTF-16 (hex) | 0x5161 (5161) |
| UTF-16 (decimal) | 20,833 |
| UTF-32 (hex) | 0x00005161 (5161) |
| UTF-32 (decimal) | 20,833 |
| C/C++/Java source code | "\u5161" |
| Python source code | u"\u5161" |
| More... | |
| Java Data | |
|---|---|
| string.toUpperCase() | 兡 |
| string.toLowerCase() | 兡 |
| Character.UnicodeBlock | CJK_UNIFIED_IDEOGRAPHS |
| Character.charCount() | 1 |
| Character.getDirectionality() | DIRECTIONALITY_LEFT_TO_RIGHT [0] |
| Character.getNumericValue() | -1 |
| Character.getType() | 5 |
| Character.isDefined() | Yes |
| Character.isDigit() | No |
| Character.isIdentifierIgnorable() | No |
| Character.isISOControl() | No |
| Character.isJavaIdentifierPart() | Yes |
| Character.isJavaIdentifierStart() | Yes |
| Character.isLetter() | Yes |
| Character.isLetterOrDigit() | Yes |
| Character.isLowerCase() | No |
| Character.isMirrored() | No |
| Character.isSpaceChar() | No |
| Character.isSupplementaryCodePoint() | No |
| Character.isTitleCase() | No |
| Character.isUnicodeIdentifierPart() | Yes |
| Character.isUnicodeIdentifierStart() | Yes |
| Character.isUpperCase() | No |
| Character.isValidCodePoint() | Yes |
| Character.isWhitespace() | No |
