
Unicode Han Character 'CJK UNIFIED IDEOGRAPH-75EC' (U+75EC) |
  |
CJK UNIFIED IDEOGRAPH-75EC
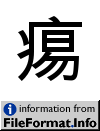
CJK UNIFIED IDEOGRAPH-75EC
| Name | CJK UNIFIED IDEOGRAPH-75EC |
| Block | CJK Unified Ideographs |
| Category | Letter, Other [Lo] |
| Script | Han (Hani) |
| Combine | 0 |
| BIDI | Left-to-Right [L] |
| Version | Unicode 1.1.0 (June, 1993) |
| Unicode Han Data | |
|---|---|
| kJapaneseOn | EKI YAKU SEKI SHAKU |
| kPhonetic | 1559* |
| kCangjie | KAPH |
| kIRG_KSource | K2-4968 |
| kIRG_TSource | T4-3E77 |
| kJapaneseKun | OROKA UTSURU |
| kRSAdobe_Japan1_6 | C+14162+104.5.8 |
| kHanYu | 42680.030 |
| kGB3 | 6302 |
| kFanqie | 羊益 |
| kCCCII | 246142 |
| kMandarin | yì |
| kTotalStrokes | 13 |
| kIRG_GSource | G3-5F22 |
| kSBGY | 517.20 |
| kJIS0213 | 2,81,52 |
| kKangXi | 0774.270 |
| kJapanese | エキ ヤク セキ シャク |
| kMojiJoho | MJ017824 |
| kRSUnicode | 104.8 |
| kJis1 | 4562 |
| kMorohashi | 22246 |
| kIRG_JSource | J14-7154 |
| kCantonese | jik6 |
| kIRGHanyuDaZidian | 42680.030 |
| kHanyuPinyin | 42680.030:yì |
| kIRG_KPSource | KP1-5BD5 |
| kDaeJaweon | 1185.130 |
| HTML Entity (decimal) | 痬 |
| HTML Entity (hex) | 痬 |
| How to type in Microsoft Windows | Alt +75EC |
| UTF-8 (hex) | 0xE7 0x97 0xAC (e797ac) |
| UTF-8 (binary) | 11100111:10010111:10101100 |
| UTF-16 (hex) | 0x75EC (75ec) |
| UTF-16 (decimal) | 30,188 |
| UTF-32 (hex) | 0x000075EC (75ec) |
| UTF-32 (decimal) | 30,188 |
| C/C++/Java source code | "\u75EC" |
| Python source code | u"\u75EC" |
| More... | |
| Java Data | |
|---|---|
| string.toUpperCase() | 痬 |
| string.toLowerCase() | 痬 |
| Character.UnicodeBlock | CJK_UNIFIED_IDEOGRAPHS |
| Character.charCount() | 1 |
| Character.getDirectionality() | DIRECTIONALITY_LEFT_TO_RIGHT [0] |
| Character.getNumericValue() | -1 |
| Character.getType() | 5 |
| Character.isDefined() | Yes |
| Character.isDigit() | No |
| Character.isIdentifierIgnorable() | No |
| Character.isISOControl() | No |
| Character.isJavaIdentifierPart() | Yes |
| Character.isJavaIdentifierStart() | Yes |
| Character.isLetter() | Yes |
| Character.isLetterOrDigit() | Yes |
| Character.isLowerCase() | No |
| Character.isMirrored() | No |
| Character.isSpaceChar() | No |
| Character.isSupplementaryCodePoint() | No |
| Character.isTitleCase() | No |
| Character.isUnicodeIdentifierPart() | Yes |
| Character.isUnicodeIdentifierStart() | Yes |
| Character.isUpperCase() | No |
| Character.isValidCodePoint() | Yes |
| Character.isWhitespace() | No |
