
Unicode Han Character 'CJK UNIFIED IDEOGRAPH-8408' (U+8408) |
  |
CJK UNIFIED IDEOGRAPH-8408
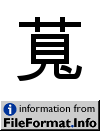
CJK UNIFIED IDEOGRAPH-8408
| Name | CJK UNIFIED IDEOGRAPH-8408 |
| Block | CJK Unified Ideographs |
| Category | Letter, Other [Lo] |
| Script | Han (Hani) |
| Combine | 0 |
| BIDI | Left-to-Right [L] |
| Version | Unicode 1.1.0 (June, 1993) |
| Unicode Han Data | |
|---|---|
| kIRG_GSource | G3-6850 |
| kCNS1986 | E-3E50 |
| kSBGY | 123.52 |
| kCangjie | TBUI |
| kGSR | 0165a |
| kKangXi | 1040.310 |
| kIRG_TSource | T3-3E50 |
| kJapanese | カン ガン |
| kMojiJoho | MJ022205 |
| kRSUnicode | 140.8 |
| kMorohashi | 31257 |
| kCihaiT | 1148.202 |
| kIRG_JSource | JMJ-022205 |
| kCantonese | wun4 |
| kKarlgren | 101 |
| kIRGHanyuDaZidian | 53233.090 |
| kHanyuPinyin | 53233.090:huán |
| kHanYu | 53233.090 |
| kCNS1992 | 3-3E50 |
| kGB3 | 7248 |
| kFanqie | 胡官 |
| kCCCII | 227E7E |
| kMandarin | huán |
| kTotalStrokes | 11 |
| HTML Entity (decimal) | 萈 |
| HTML Entity (hex) | 萈 |
| How to type in Microsoft Windows | Alt +8408 |
| UTF-8 (hex) | 0xE8 0x90 0x88 (e89088) |
| UTF-8 (binary) | 11101000:10010000:10001000 |
| UTF-16 (hex) | 0x8408 (8408) |
| UTF-16 (decimal) | 33,800 |
| UTF-32 (hex) | 0x00008408 (8408) |
| UTF-32 (decimal) | 33,800 |
| C/C++/Java source code | "\u8408" |
| Python source code | u"\u8408" |
| More... | |
| Java Data | |
|---|---|
| string.toUpperCase() | 萈 |
| string.toLowerCase() | 萈 |
| Character.UnicodeBlock | CJK_UNIFIED_IDEOGRAPHS |
| Character.charCount() | 1 |
| Character.getDirectionality() | DIRECTIONALITY_LEFT_TO_RIGHT [0] |
| Character.getNumericValue() | -1 |
| Character.getType() | 5 |
| Character.isDefined() | Yes |
| Character.isDigit() | No |
| Character.isIdentifierIgnorable() | No |
| Character.isISOControl() | No |
| Character.isJavaIdentifierPart() | Yes |
| Character.isJavaIdentifierStart() | Yes |
| Character.isLetter() | Yes |
| Character.isLetterOrDigit() | Yes |
| Character.isLowerCase() | No |
| Character.isMirrored() | No |
| Character.isSpaceChar() | No |
| Character.isSupplementaryCodePoint() | No |
| Character.isTitleCase() | No |
| Character.isUnicodeIdentifierPart() | Yes |
| Character.isUnicodeIdentifierStart() | Yes |
| Character.isUpperCase() | No |
| Character.isValidCodePoint() | Yes |
| Character.isWhitespace() | No |
