
Unicode Han Character 'to sleep; to realize, feel' (U+8990) |
  |
to sleep; to realize, feel
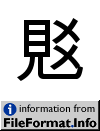
to sleep; to realize, feel
| Name | to sleep; to realize, feel |
| Block | CJK Unified Ideographs |
| Category | Letter, Other [Lo] |
| Script | Han (Hani) |
| Combine | 0 |
| BIDI | Left-to-Right [L] |
| Version | Unicode 1.1.0 (June, 1993) |
| Unicode Han Data | |
|---|---|
| kIRG_GSource | GE-4C4D |
| kJapaneseOn | KAKU |
| kLau | 950 |
| kCangjie | BUKK |
| kSemanticVariant | U+89BA<kMatthews |
| kJIS0213 | 2,88,39 |
| kKangXi | 1133.120 |
| kIRG_TSource | T4-3534 |
| kJapanese | カク |
| kMojiJoho | MJ024223 MJ024223:E0101 MJ024224:E0102 MJ068066:E0103 |
| kRSUnicode | 147.4 |
| kMatthews | 1178 |
| kJis1 | 6106 |
| kDefinition | to sleep; to realize, feel |
| kMorohashi | 34811 34811:E0101 |
| kIRG_JSource | J14-7847 |
| kJapaneseKun | OBOOERU SAAMASU SAAMERU |
| kCantonese | gok3 |
| kRSAdobe_Japan1_6 | C+18659+89.4.7 C+18659+147.7.4 |
| kIRGHanyuDaZidian | 63665.140 |
| kHanYu | 63665.140 |
| kDaeJaweon | 1600.040 |
| kMandarin | jué |
| kTotalStrokes | 11 |
| HTML Entity (decimal) | 覐 |
| HTML Entity (hex) | 覐 |
| How to type in Microsoft Windows | Alt +8990 |
| UTF-8 (hex) | 0xE8 0xA6 0x90 (e8a690) |
| UTF-8 (binary) | 11101000:10100110:10010000 |
| UTF-16 (hex) | 0x8990 (8990) |
| UTF-16 (decimal) | 35,216 |
| UTF-32 (hex) | 0x00008990 (8990) |
| UTF-32 (decimal) | 35,216 |
| C/C++/Java source code | "\u8990" |
| Python source code | u"\u8990" |
| More... | |
| Java Data | |
|---|---|
| string.toUpperCase() | 覐 |
| string.toLowerCase() | 覐 |
| Character.UnicodeBlock | CJK_UNIFIED_IDEOGRAPHS |
| Character.charCount() | 1 |
| Character.getDirectionality() | DIRECTIONALITY_LEFT_TO_RIGHT [0] |
| Character.getNumericValue() | -1 |
| Character.getType() | 5 |
| Character.isDefined() | Yes |
| Character.isDigit() | No |
| Character.isIdentifierIgnorable() | No |
| Character.isISOControl() | No |
| Character.isJavaIdentifierPart() | Yes |
| Character.isJavaIdentifierStart() | Yes |
| Character.isLetter() | Yes |
| Character.isLetterOrDigit() | Yes |
| Character.isLowerCase() | No |
| Character.isMirrored() | No |
| Character.isSpaceChar() | No |
| Character.isSupplementaryCodePoint() | No |
| Character.isTitleCase() | No |
| Character.isUnicodeIdentifierPart() | Yes |
| Character.isUnicodeIdentifierStart() | Yes |
| Character.isUpperCase() | No |
| Character.isValidCodePoint() | Yes |
| Character.isWhitespace() | No |
